Un piège attend presque tous les développeurs qui construisent leur premier frontend headless avec l’API REST WordPress : récupérer une liste d’articles, puis se rendre compte qu’il faut une requête supplémentaire par article pour obtenir le nom de l’auteur, une autre pour l’image mise en avant, une autre encore pour les catégories. Dix articles affichés peuvent ainsi déclencher plusieurs dizaines de requêtes HTTP.
Ce problème, bien connu sous le nom de requêtes en cascade ou « N+1 », n’est pas une fatalité : l’API REST WordPress propose une solution intégrée depuis longtemps, le paramètre _embed. Combiné à une pagination correctement exploitée, il transforme un frontend poussif en interface rapide.
Le problème du N+1 en pratique
Prenons un cas concret. Une page d’accueil doit afficher dix articles avec, pour chacun, le nom de l’auteur et l’image mise en avant. Une implémentation naïve ressemble à ceci :
const reponse = await fetch( '/wp-json/wp/v2/posts?per_page=10' );
const articles = await reponse.json();

for ( const article of articles ) {
    const auteur = await fetch( `/wp-json/wp/v2/users/${ article.author }` );
    const image  = await fetch( `/wp-json/wp/v2/media/${ article.featured_media }` );
    // ... vingt requêtes supplémentaires pour dix articles
}
Ce code fonctionne, mais il est lent, fragile face à la latence réseau, et met une charge inutile sur le serveur WordPress. C’est exactement le genre de problème qui passe inaperçu en développement local et explose en production sous une vraie charge d’utilisateurs.
La solution : le paramètre _embed
En ajoutant simplement _embed à la requête, WordPress inclut automatiquement les ressources associées directement dans la réponse, sous la clé _embedded :
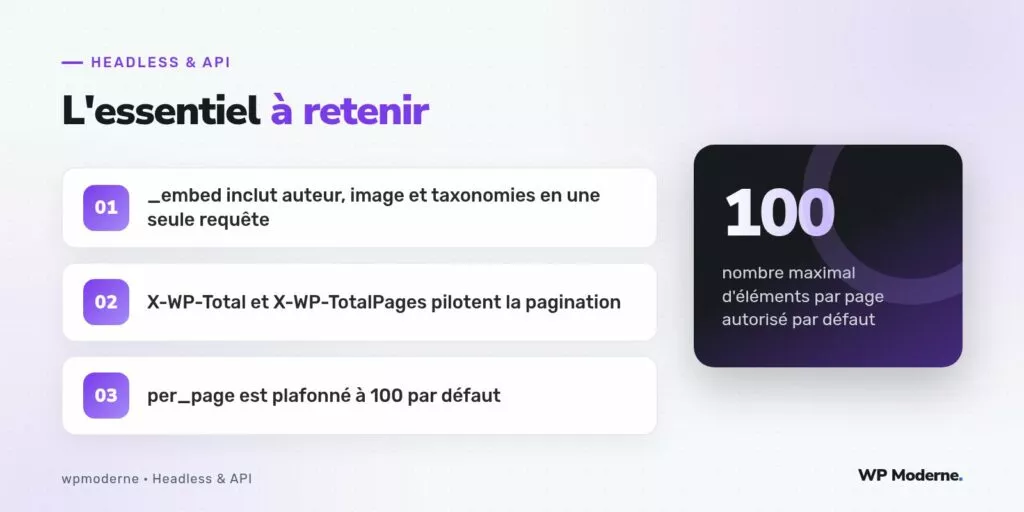
fetch( '/wp-json/wp/v2/posts?per_page=10&_embed' );La réponse contient alors, pour chaque article, un objet _embedded avec author, wp:featuredmedia, wp:term (catégories et étiquettes) et les éventuels commentaires. Une seule requête HTTP remplace ce qui en demandait auparavant des dizaines.
Cibler précisément les ressources incluses
Inclure systématiquement toutes les ressources associées peut alourdir la réponse inutilement, surtout si vous n’avez besoin que de l’image mise en avant. Depuis WordPress 5.4, il est possible de cibler précisément les relations à inclure avec _embed[] :
fetch( '/wp-json/wp/v2/posts?per_page=10&_embed[]=author&_embed[]=wp:featuredmedia' );Cette syntaxe évite d’alourdir la réponse avec des données inutiles, un vrai gain quand la liste de commentaires ou les taxonomies ne sont pas nécessaires sur une page donnée.
Alléger encore avec _fields
Dans le même esprit d’optimisation, le paramètre _fields permet de ne demander que les champs strictement nécessaires, ce qui réduit à la fois la taille de la réponse et le temps de traitement côté serveur :
fetch( '/wp-json/wp/v2/posts?_fields=id,title,slug,excerpt' );Combiner _embed[] ciblé et _fields donne des réponses nettement plus légères, un point non négligeable sur un site à fort trafic ou hébergé avec une bande passante limitée.
Maîtriser la pagination
La pagination de l’API REST repose sur deux paramètres de requête et deux en-têtes de réponse :
page— le numéro de page demandé, à partir de 1per_page— le nombre d’éléments par page, 10 par défautX-WP-Total(en-tête de réponse) — le nombre total d’éléments correspondant à la requêteX-WP-TotalPages(en-tête de réponse) — le nombre total de pages disponibles
const reponse = await fetch( '/wp-json/wp/v2/posts?page=2&per_page=20' );
const totalPages = reponse.headers.get( 'X-WP-TotalPages' );
const articles = await reponse.json();
Un point souvent oublié : per_page est plafonné à 100 par défaut, une limite fixée dans le cœur de WordPress pour éviter les requêtes trop coûteuses. Demander per_page=500 renverra une erreur plutôt que cinq cents résultats. Pour un catalogue volumineux, il faut donc concevoir la pagination côté frontend en conséquence, plutôt que de tenter de tout récupérer en un seul appel.
Sur un projet avec plusieurs milliers d’articles, nous avons vu une équipe tenter de forcer
per_page=999pour « tout récupérer en une fois » lors du build d’un site statique. Résultat : une erreur 400 silencieusement ignorée et un site publié avec une liste d’articles incomplète pendant plusieurs jours.
En résumé
_embed et une pagination bien maîtrisée forment la base d’une intégration REST performante. Trois réflexes à conserver : ciblez les relations réellement nécessaires avec _embed[], allégez la réponse avec _fields quand c’est pertinent, et concevez toujours votre logique de pagination en tenant compte du plafond de 100 éléments par page. Ces optimisations, simples à mettre en œuvre, évitent des ralentissements qui deviennent vite visibles pour les utilisateurs finaux.